脉动阵列(1):基础知识
脉动阵列(Systolic Array)
1. 介绍
本目录提供一个 二维脉动阵列 的 Python 仿真,用于计算矩阵乘法。
- 输入矩阵:
A的形状是(m, k),B的形状是(k, n) - 输出矩阵:
C = A @ B,形状是(m, n)
阵列由 m × n 个处理单元(PE)组成。每个 PE 在每个周期执行一次乘加(MAC):
acc[i, j] = acc[i, j] + in_a * in_bin_a向右传递in_b向下传递
注意事项
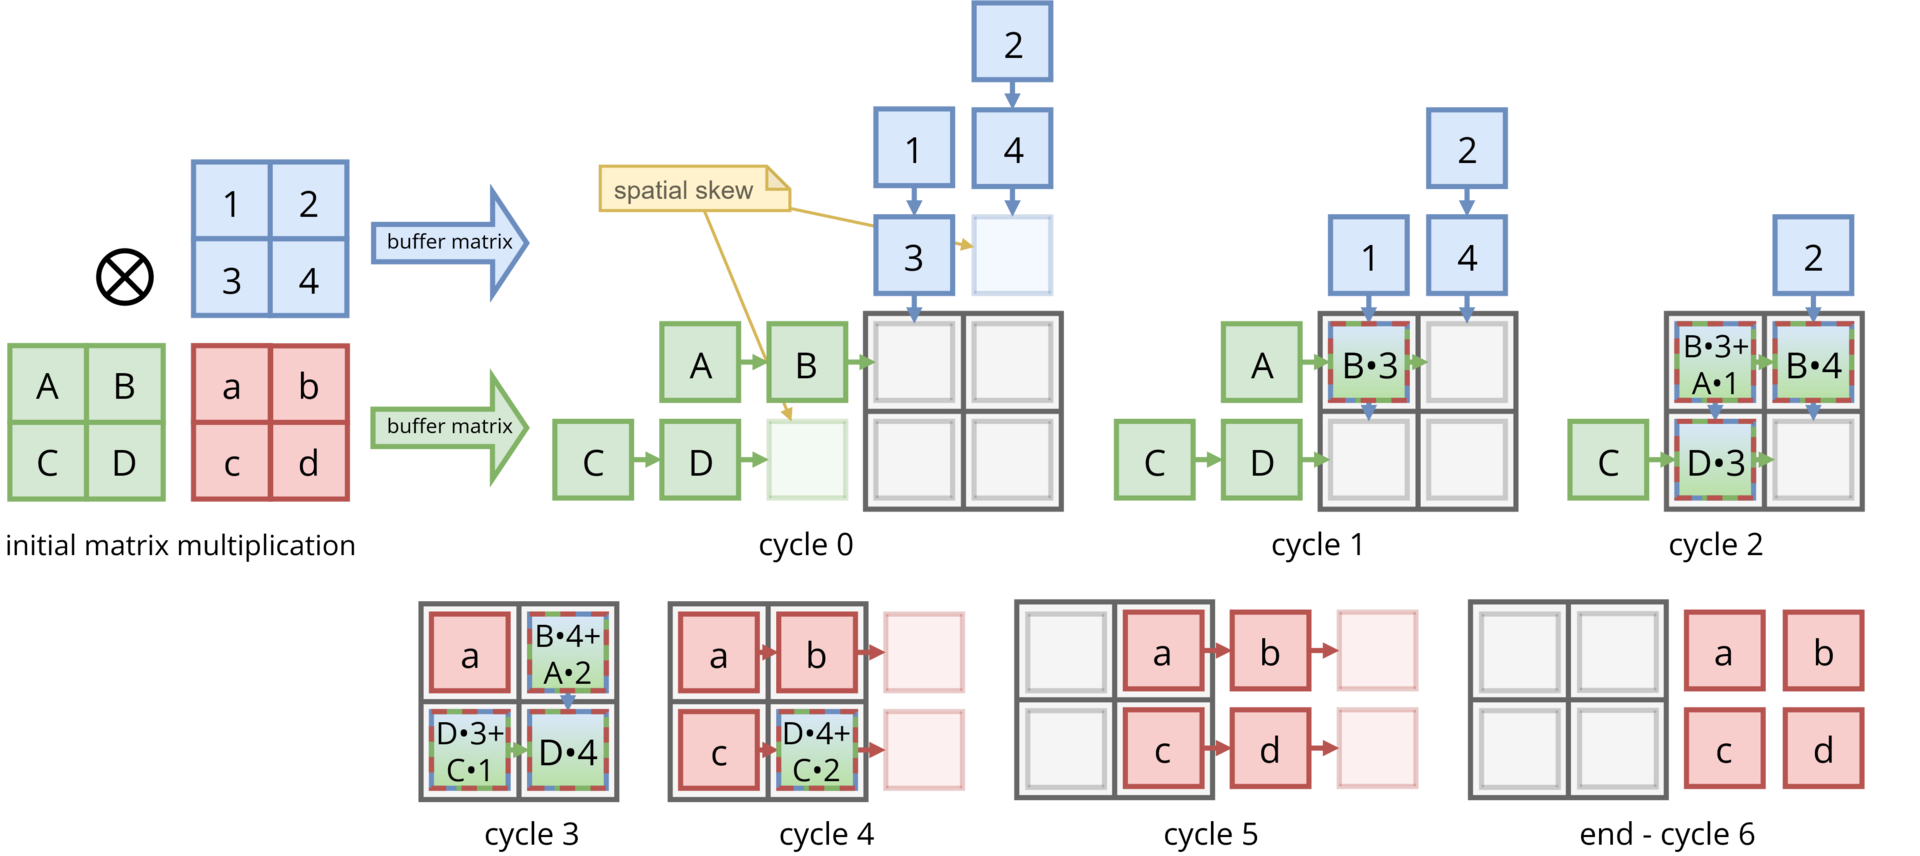
参考代码中和文档的叙述中,都是以不先存储矩阵(非权重驻留)的方法展示。
假如绿色部分是矩阵 L,蓝色部分是矩阵 T,输出矩阵为 C。由上图你可以看出,要生成 C 的某一行,需要知道整个矩阵 T 的内容,所以在看到完整的 T 之前,你实际上无法生成 C 的任何一行。
同理,要生成 C 的某一列,需要知道整个矩阵 L 的内容,所以在看到完整的 L 之前,你实际上无法生成 C 的任何一列。
正因如此,在真实系统中,通常是先把整个矩阵 L 输入到脉动阵列中并存储起来(权重驻留),然后才开始处理矩阵 T 的各行;或者把整个矩阵 T 输入到脉动阵列中并存储起来,然后才开始处理矩阵 L 的各列。
下图展示了把整个矩阵 L 输入到脉动阵列中并存储起来,然后才开始处理矩阵 T 的各行的情况。
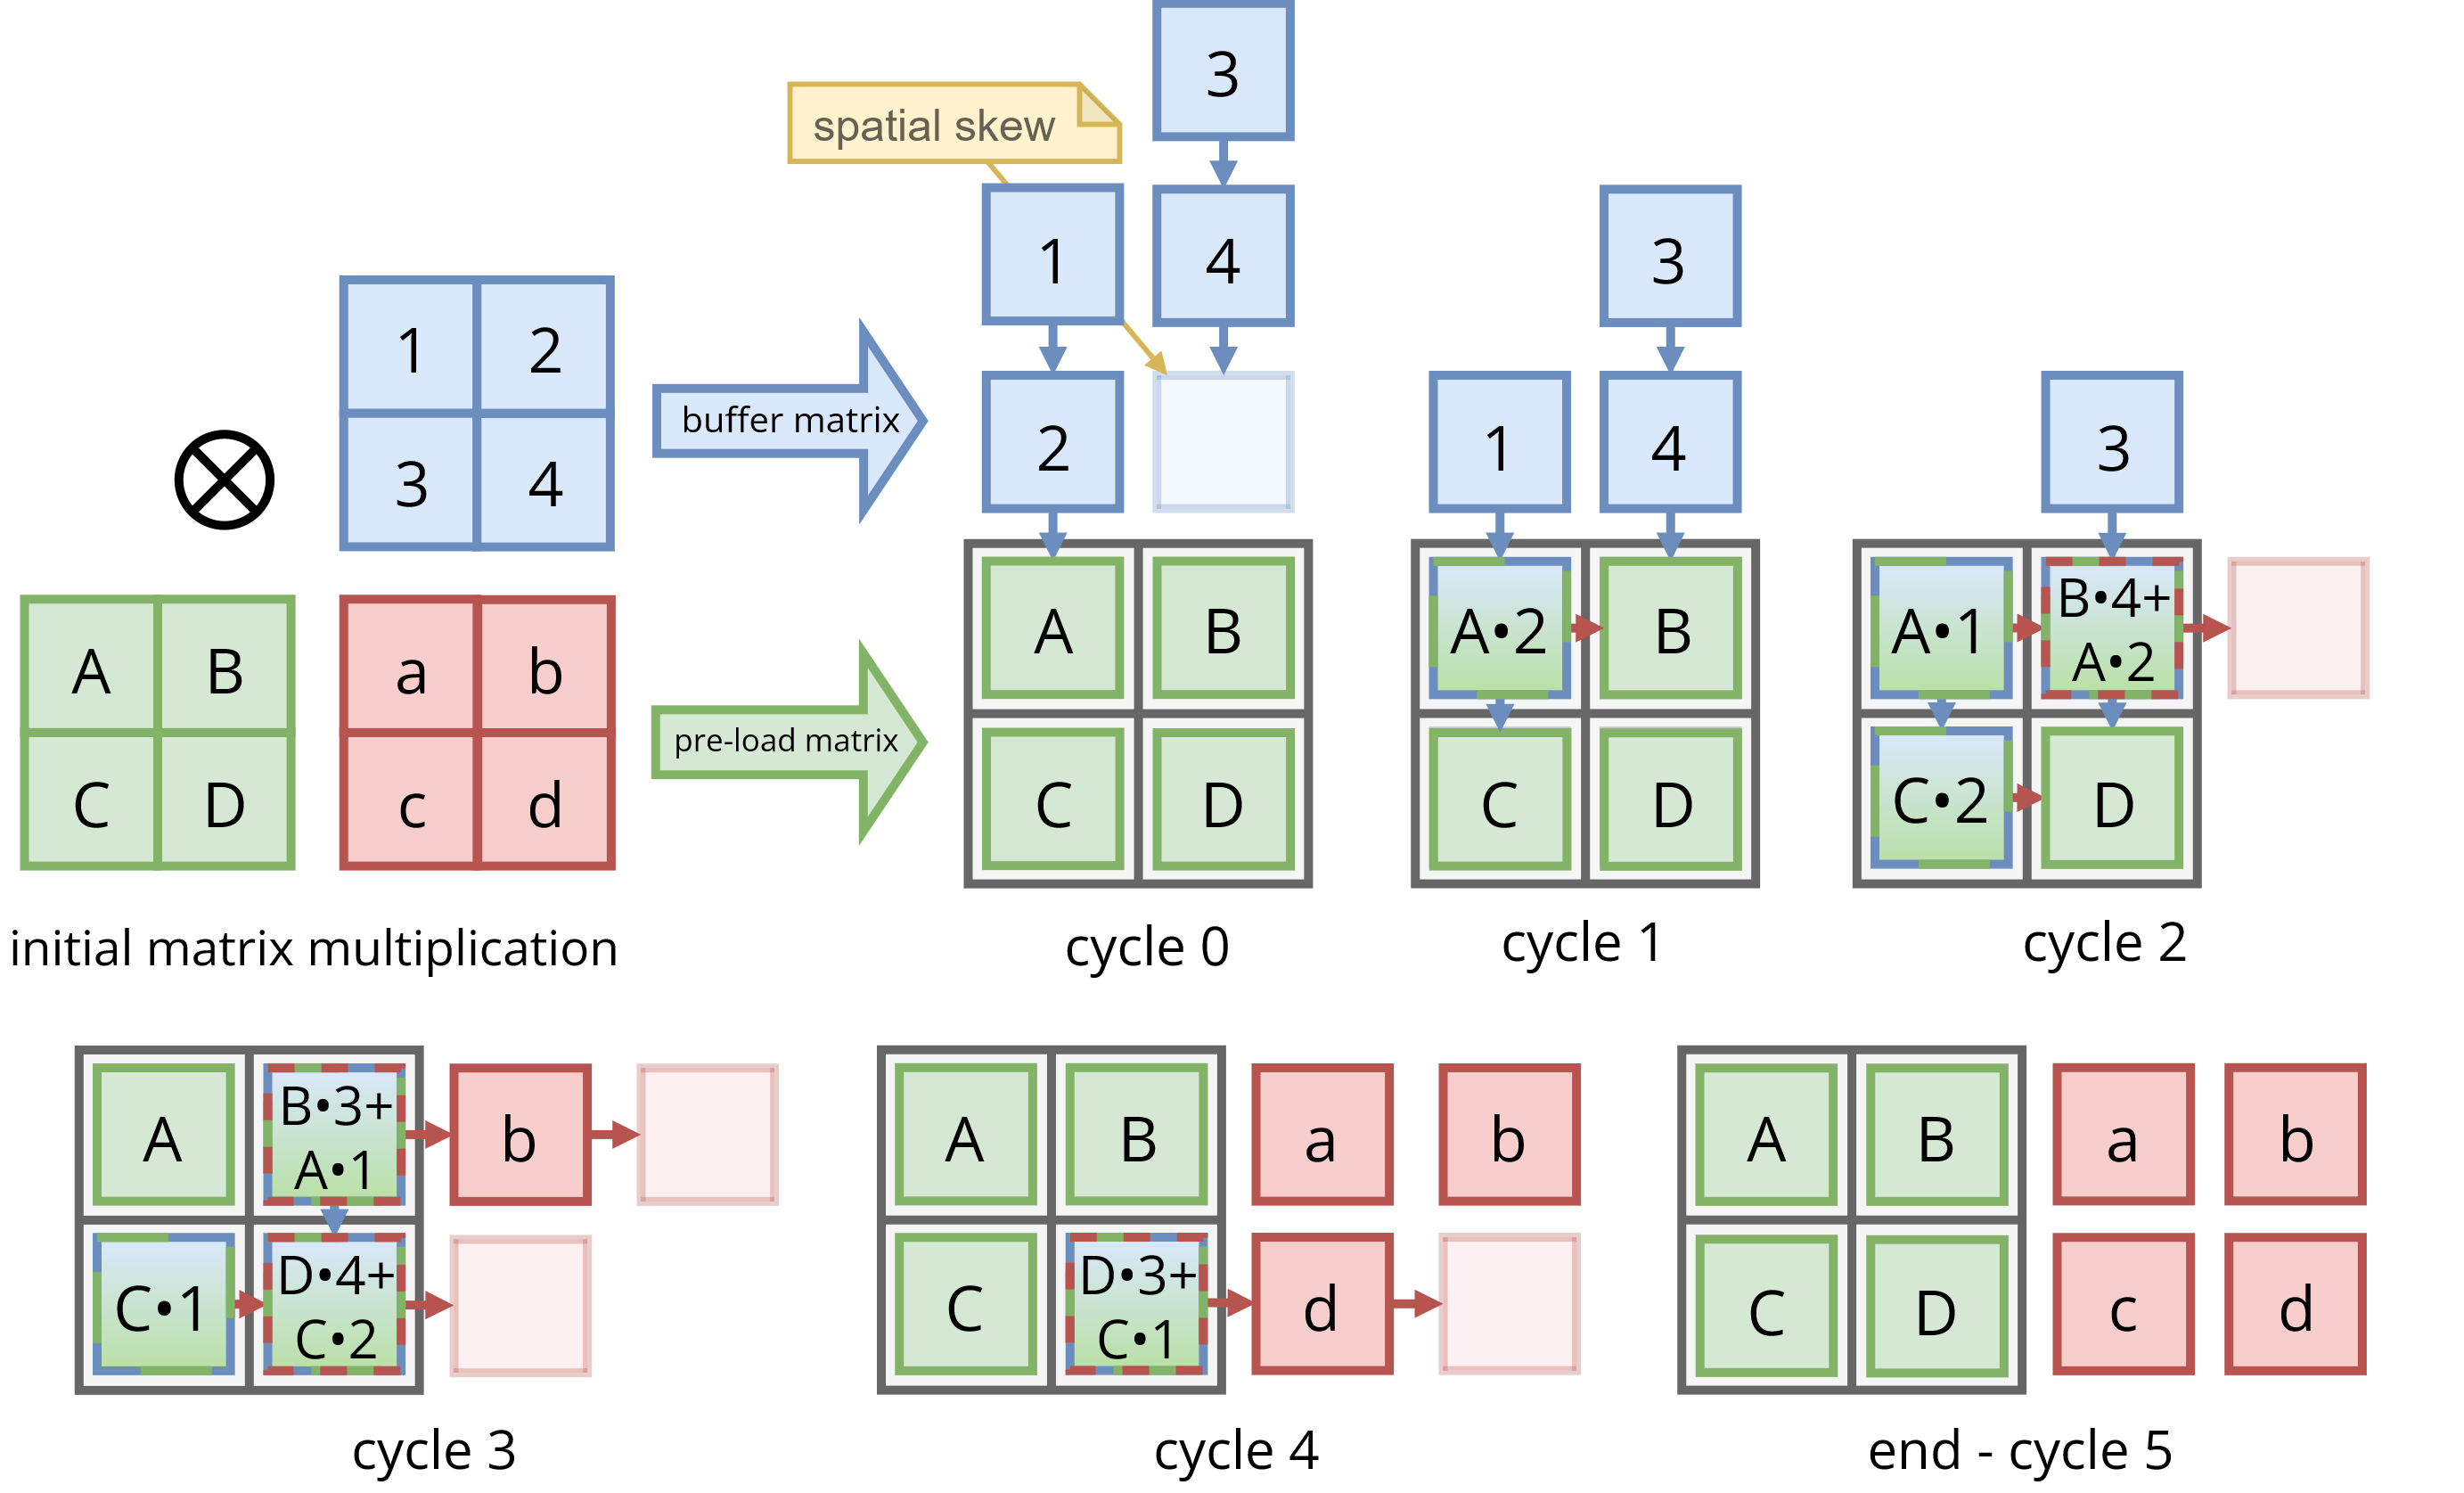
注意: 上面这副图的蓝色矩阵的 Spatial Skew 是搞错了的。
2. 关键规律(与代码一致)
对于 A(m×k) @ B(k×n):
-
输入倾斜(skew)规则
A[i, p]在周期t = i + p注入第i行左侧B[p, j]在周期t = j + p注入第j列上侧
-
脉动阵列计算矩阵总耗费周期数
total_cycles = m + n + k - 2
3. 代码说明(systolic_array.py)
-
PE (脉动阵列 cell)compute(in_a, in_b):执行乘加,保存下一拍输出clock_tick():更新out_a和out_b
-
generate_skewed_inputs(A, B)- 根据
A、B生成倾斜输入序列A_inputs与B_inputs - 返回
A_inputs、B_inputs、total_cycles
- 根据
-
simulate_systolic_array(A, B)- 构建
m × n的 PE 网格 - 每个周期执行“先 compute、后 clock_tick”
- 返回
C、history、A_inputs、B_inputs
- 构建
-
print_cycle_history(history)- 打印每个周期的 PE 累加值
-
plot_systolic_history(history, m, n)- 可视化每个周期的数据输入、PE 状态和数据流向
4. 使用方式
python .\systolic_array.py运行后会:
- 生成并打印
A_inputs/B_inputs - 打印每个周期的累加状态
- 输出
C与A @ B对比结果 - 绘制每个周期的数据流动图
5. 补充
假设:
- 绿色部分对应矩阵
- 蓝色部分对应矩阵
- 输出矩阵为
并且有:
5.1 矩阵定义
矩阵 是一个 矩阵:
矩阵 是一个 矩阵:
输出矩阵 也是一个 矩阵:
5.2 矩阵乘法展开
由
可得:
5.3 为什么生成 的某一行需要知道整个矩阵
例如,C 的第 0 行为:
其中:
可以看到,要计算 和 ,不仅需要矩阵 的第 0 行:
还需要矩阵 的第 0 列和第 1 列:
也就是说,要生成 的某一行,实际上需要知道矩阵 的完整内容。
5.4 为什么生成 的某一列需要知道整个矩阵
例如,C 的第 0 列为:
其中:
可以看到,要计算 和 ,不仅需要矩阵 的第 0 列:
还需要矩阵 的第 0 行和第 1 行:
也就是说,要生成 的某一列,实际上需要知道矩阵 的完整内容。
5.5 结合脉动阵列的说明
正因如此,在真实系统中,通常会采用以下两种方式之一:
方式 1:先存储整个矩阵
先将整个矩阵 输入到脉动阵列中并存储起来:
然后再开始处理矩阵 的各行。
方式 2:先存储整个矩阵
先将整个矩阵 输入到脉动阵列中并存储起来:
然后再开始处理矩阵 的各列。
评论